在上篇的「深入分析」中,我們討論了NVIDIA用各種線纜和晶片組成的「硬體護城河」。 那是一道看得見的牆,就像樂高積木一樣,雖然複雜,但你至少能看到它的形狀和結構。 但是,NVIDIA帝國最堅固的防線,其實是一道看不見的牆。它不是由硬體構成,而是由軟體編織而成。這個軟體的名字,叫做 CUDA。 想像一下,你為什麼選擇使用Windows或macOS作業系統?是因為它們的電腦外殼更漂亮嗎?不完全是。 你選擇它們,是因為你習慣了它們的操作方式,更重要的是,所有你需要的軟體——從Office辦公套件到Photoshop,再到各種遊戲——都只能在這些系統上完美運行。
過去十五年,NVIDIA投入了無數資源,讓全世界最聰明的開發者和科學家都習慣於在CUDA這個「系統」上工作。 久而久之,這形成了一種巨大的依賴性。這份依賴,比任何硬體連接都更難以撼動。它是一種看不見的引力,把所有人都牢牢吸附在NVIDIA的生態系統裡。 這篇文章,我將為您揭開這個「軟體帝國」的秘密:
讓我們回到故事的開頭,看看CUDA是如何誕生的。 在開始之前,想跟大家同步一下本週文章的小變動。我目前人正在外地和家人旅遊,雖然旅途中仍心繫市場,但考量到寫作一篇深度研究需要非常專注的狀態和完整的資料庫支援,為了不辜負大家對內容的期待,我認為倉促地在本週趕出兩篇文章,並不是最好的做法。 所以,我做了一點小小的調動:
這也意味著,下週大家會一次收到兩篇熱騰騰的深度文章!文章總數一篇都不會少,只是讓我能用最好的狀態,把最好的內容呈現給你。 謝謝你的理解和支持,讓我們繼續! 第一章:CUDA創世紀
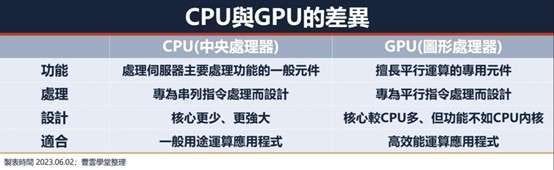
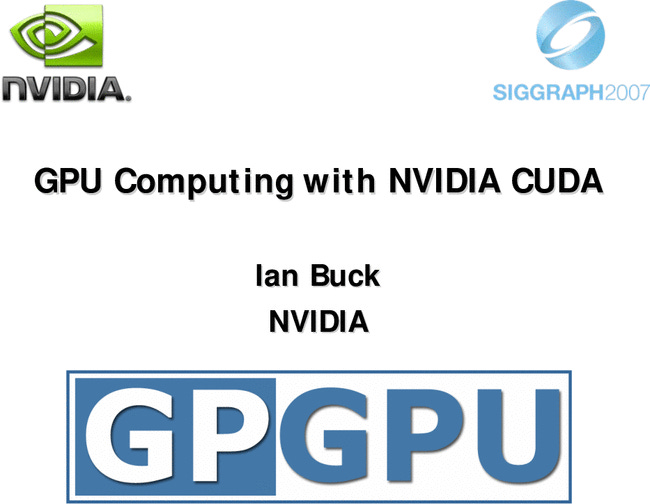
在CUDA誕生前,電腦核心住著兩位員工:CPU,一位能處理複雜邏輯的「超級博士」,但他分身乏術;GPU,一支由成千上萬士兵組成的「人海大軍」,只會簡單指令卻能同時開工。 這支大軍曾是「繪圖特種兵」,語言不通,只能透過DirectX和OpenGL等高度特化的「繪圖指揮部」接受命令。程式設計師無法直接指揮它進行通用計算——這扇大門是緊鎖的。 風暴前的「黑魔法師」 然而,對強大算力的渴望無法被禁錮。CUDA出現前,一小群頂尖科學家,如同中世紀的煉金術士,發明了一種被稱為GPGPU (通用圖形處理器編程) 的「黑魔法」。 他們用極其巧妙的方式,將自己的科學問題「偽裝」成繪圖問題來欺騙GPU。 例如,一位想計算大型矩陣乘法的科學家,會對GPU說:「我這裡有兩張特殊的『圖片』(矩陣數字編碼成像素顏色),請你用特製的『濾鏡』(乘法運算偽裝成渲染效果)處理,再把生成的新『圖片』交給我。」科學家拿到結果後,再將顏色解碼還原成數據。 這個過程痛苦、複雜、效率低落,且僅有極少數天才得以掌握。它就像逼迫畫家寫小說,你只能給他顏料,讓他把每個字都「畫」出來。 然而,這些「黑魔法師」的存在,向NVIDIA傳遞了一個無比清晰的信號:市場對通用、大規模並行計算存在巨大渴求,只缺一把好用的鑰匙。 革命的火花 —— CUDA的誕生 NVIDIA的高層與工程師憑藉敏銳洞察,決定親手打造那把鑰匙。CUDA的誕生,並非偶然的賭博,而是一場匯集了技術演進、學術契機與宏大商業遠見的完美風暴。
這種敢於為未來下大注的基因,深植於NVIDIA的歷史。 從90年代末瀕臨破產時,傾盡所有豪賭RIVA 128晶片,用頂級硬體與微軟標準的結合死裡逃生;到AI浪潮前夕,慷慨地將當時世界最強的AI超算DGX-1捐贈給尚名不見經傳的OpenAI。 NVIDIA的戰略一以貫之:用最頂尖的硬體定義市場,再用最前瞻的軟體生態鎖定未來。每一次看似冒險的投資,都是對未來生態的精準佈局。 於是,2006年,CUDA (Compute Unified Device Architecture, 統一計算設備架構) 正式問世。
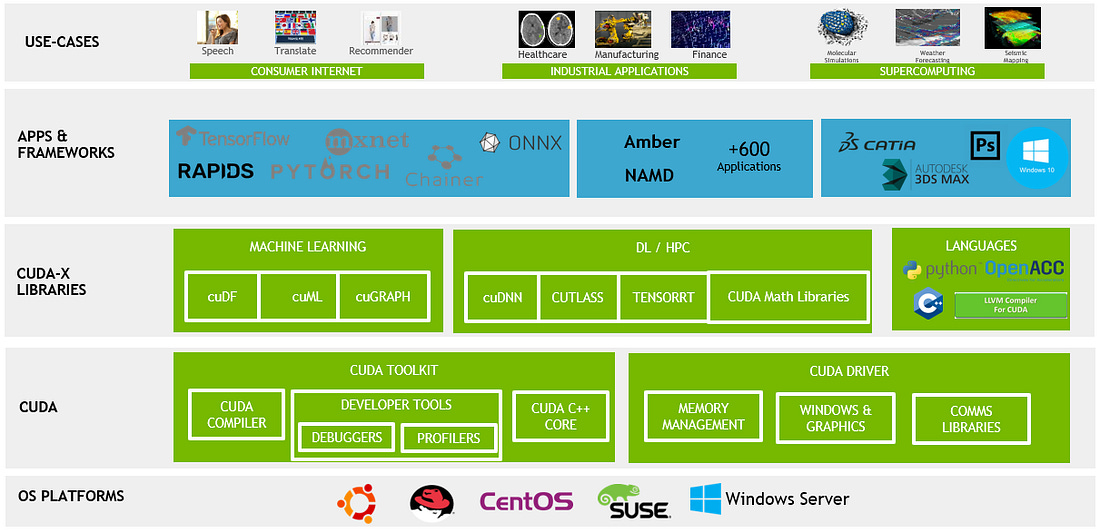
CUDA究竟是什麼?它就是「指揮手冊」與「翻譯官兼總指揮」的集合體。
降維打擊與無心插柳 CUDA推出時,AI仍在學術的象牙塔中沉睡。NVIDIA的首要目標,是一個已存在且利潤豐厚的市場:高效能運算 (HPC)。
他們的策略是「降維打擊」——用相對廉價、可大規模部署的GPU方案,去搶佔原本屬於昂貴專用超級電腦的市場。
這是一個極其穩健的商業計畫,為NVIDIA帶來了豐厚回報。 然而,一個他們未曾預料的巨浪,即將到來。 根據NVIDIA現任首席科學家Bill Dally回憶,歷史的轉捩點發生在2011年。當時他的史丹佛同事、AI先驅吳恩達(Andrew Ng)在Google Brain用16,000顆CPU在網路上尋找貓的圖片。 Dally意識到GPU的潛力,指派了一位研究員與吳恩達合作,最終僅用48顆NVIDIA GPU就實現了更快的速度。這個專案的成果,直接催生了cuDNN函式庫的誕生,為即將到來的深度學習革命奠定了基礎。 一年後的2012年,Geoffrey Hinton的團隊使用兩張NVIDIA GPU,透過CUDA訓練出神經網路AlexNet,在全球權威的ImageNet圖像識別大賽中以碾壓性優勢奪冠。 這聲巨響,震驚了整個科技界。 它證明了「深度學習 + 強大算力 (GPU)」這條道路的正確性。對NVIDIA而言,他們驚訝地發現,為HPC市場打造的工具,竟在一個未曾預料的領域引爆了一場革命。AI市場的潛力,遠比他們想像的任何市場都龐大。 從此,CUDA的應用場景呈爆炸式擴散。它不僅是學術研究的利器,更成為了產業變革的核心引擎:從DeepMind用AlphaFold解開蛋白質摺疊之謎,到特斯拉利用其進行自動駕駛模型的訓練,甚至在加密貨幣的浪潮中,無數的GPU也曾夜以繼日地為加密貨幣挖礦而轟鳴。CUDA的影響力早已超出了NVIDIA最初的設想。的設想。
第二章:究竟CUDA是甚麼?
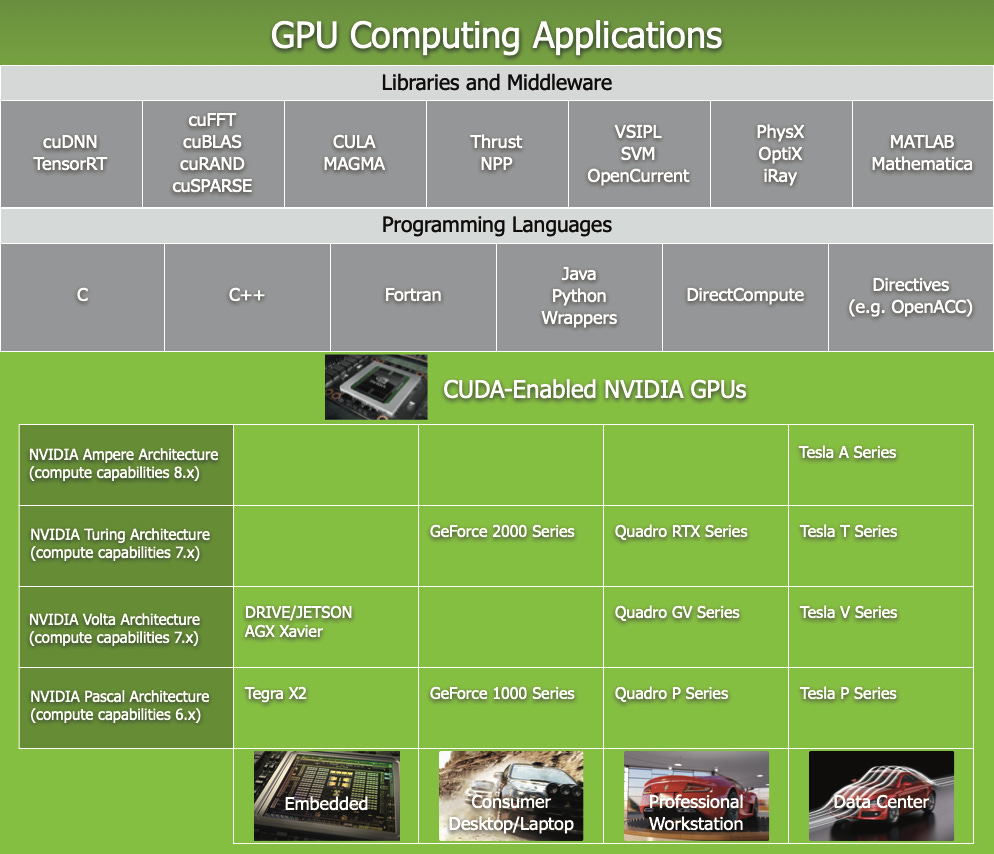
當我們談論 NVIDIA 在 AI 領域的霸主地位時,許多人會想到他們的 GPU 硬體。但這只看到了冰山一角。NVIDIA 真正打造的並非單一產品,而是一個精心雕琢、環環相扣的「四位一體」開發者王國。 這個王國的設計初衷,就是讓所有進入的開發者,都能感受到前所未有的強大與便捷,最終舒適地「定居」下來,再也不想離開。 想像一下,您想蓋一座史上最宏偉、最酷炫的樂高城堡。NVIDIA 的 GPU 顯示卡,就像是給了您一座堆積如山的樂高積木,擁有無限的可能性。 而 CUDA,就是您蓋城堡時,附贈的一套「超級豪華魔法工具箱」。這套工具箱裡,有四樣緊密配合的法寶: 第一重:王國的基礎法則 —— 編程模型與 API 這是 CUDA 王國的「物理定律」,是一切的基石。它定義了開發者如何與 GPU 這片新大陸溝通的「官方語言」。 它用清晰的規則告訴你:如何定義一個可以在 GPU 上運行的核心程式(Kernels),如何組織和指揮那成千上萬的計算士兵(管理線程 Threads),以及如何在 CPU 指揮官和 GPU 大軍之間高效地傳遞糧草與數據(管理記憶體)。 例如,開發者會使用一個特殊的關鍵字 【用樂高來理解】 第二重:現成的神兵利器 —— 殺手級函式庫 (Libraries)
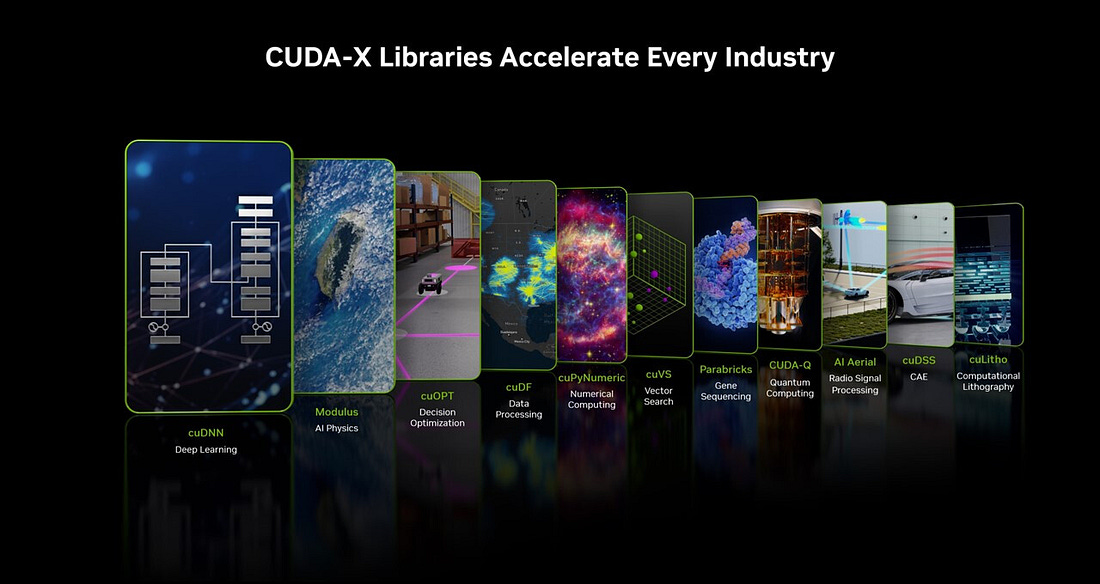
這才是 CUDA 生態系真正的靈魂,也是 NVIDIA 最具智慧的一步。NVIDIA 深知,不是每位開發者都有時間或精力,從零開始創造複雜的底層演算法。 於是,NVIDIA 聘請了數千名全球頂尖的博士與工程師,為開發者預先打造好了一套套威力無窮、針對自家硬體優化到極致的「傳世武功秘籍」。這就是函式庫。NVIDIA官方將其打包為 CUDA-X,一個包含超過 900個 專用函式庫、框架和模型的龐大集合。
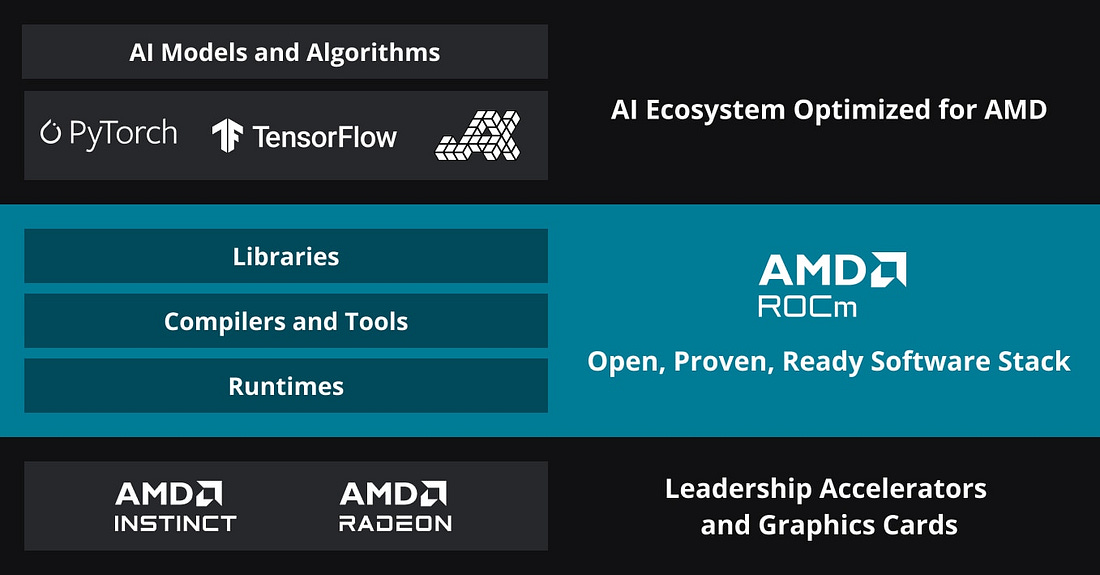
NVIDIA為幾乎每一個需要龐大算力的垂直領域,都鍛造了一把專屬的「屠龍刀」。相比之下,其主要競爭對手AMD ROCm的核心函式庫數量約在50-100個之間,規模相差近 9到18倍。 這些函式庫,讓開發者無需從「蹲馬步」開始練起,可以直接調用這些千錘百鍊的招式,發揮驚人威力。 【用樂高來理解】 第三重:忠誠的專屬譯者 —— NVCC 編譯器 開發者用 CUDA C++ 寫下的「高階指令」,如同優美的詩篇,但 GPU 大軍的士兵們只聽得懂最直接、最簡潔的戰吼。NVCC 編譯器,就是這位至關重要的「專屬翻譯官」。 它不僅僅是翻譯,更是一位深諳兵法的軍師。它深刻理解每一代 NVIDIA GPU(如 Hopper、Blackwell 架構)的細微差異,能將開發者的意圖,翻譯成最能榨乾硬體潛能的機器指令,確保每一分電力都轉化為實實在在的算力。 【用樂高來理解】 第四重:全知的透視神鏡 —— 分析與除錯工具 最後,NVIDIA 還提供了一整套如同「醫療儀器」般的工具,例如 Nsight Profiler(性能分析器)和 CUDA-GDB(除錯器)。 這些工具賦予了開發者一雙「透視神鏡」。他們能像一位神醫,為自己的程式碼「聽診」,精準地找出性能瓶頸;也能像一位偵探,深入 GPU 運行的內部,揪出隱藏的錯誤。這極大地降低了開發和優化的難度。 【用樂高來理解】 或者,如果發現西邊的牆蓋得特別慢,眼鏡會告訴您:「喔,是因為您用了太多小積木了,建議直接換上一大片預先蓋好的牆壁零件。」 結論:歡迎來到這個無法離開的世界 因此,當一位 AI 研究員選擇 NVIDIA 的 GPU 時,他得到的絕不僅僅是一塊冰冷的硬體。 他得到的是一整套從思想到實踐的完整解決方案。NVIDIA 提供的不是一條魚,甚至不是一支釣竿。 它提供的是:一片蘊藏豐富魚群的專屬海洋、一支由最高效漁船組成的艦隊、一部能探測所有魚群位置的聲納儀,以及一本代代相傳、繪滿了所有航道與暗礁的航海日誌。
而這個世界的引力,正是 NVIDIA 最深、最難以被複製的護城河。
第三章:引力的深淵——CUDA的同心圓鎖定
這股強大的引力由四個層層遞進的同心圓構成,越靠近核心,引力越是無可抗拒。 第一層引力(最外層):生態系統的軌道
引力場的最外層,是那些看似獨立運行的「行星」——以PyTorch和TensorFlow為首的深度學習框架。 那麼,PyTorch 和 TensorFlow 究竟是什麼?您可以把它們想像成是設計 AI 的「大腦」或「藍圖」。 它們負責規劃 AI 的結構和任務,例如訓練一個像 ChatGPT 這樣的語言模型。 然而,光有藍圖不夠,還需要強大的「肌肉」來執行海量的運算。NVIDIA 的 GPU 就是這塊「肌肉」。而 CUDA,就是連接「大腦」與「肌肉」的專用神經系統。 它是一種特殊的語言,能讓 PyTorch 設計的複雜任務,完美地交給 NVIDIA 的 GPU 高速執行。沒有這個神經系統,兩者之間的溝通就會變得極其低效。 理解了這層關係,我們就能看清NVIDIA的策略。 從PyTorch等框架誕生之初,NVIDIA就投入了海量資源進行合作與優化。結果是什麼?這些框架的預設高性能後端,就是基於CUDA和cuDNN(NVIDIA的深度神經網路庫)的。 當一個數據科學家輸入 這形成了一種微妙的綁定:框架本身是自由的,但追求極致性能的路徑卻只有一條,那就是通往NVIDIA GPU。 就像一顆衛星,PyTorch雖然擁有自己的運行軌道,但它始終圍繞著NVIDIA這個巨大的引力核心旋轉。 它將數百萬用戶和開發者一同帶入了這個軌道,讓他們在不知不覺中成為了CUDA引力場的一部分。 想要讓PyTorch在其他硬體(如AMD的GPU)上達到同等性能和穩定性,就需要付出不成比例的巨大努力,這就是第一層引力鎖定。 第二層引力(中間層):程式碼資產的行星帶
當你更深入引力場,你會撞上一片由數億行程式碼構成的、密不透風的「行星帶」。這就是企業和研究機構多年來積累的CUDA程式碼資產。 這些程式碼不僅僅是演算法,更包含了大量為特定NVIDIA GPU架構手動優化的kernel(核心函數)、數值計算庫和數據處理流程。 它們是無數工程師耗費心血,為了榨乾硬體最後一絲性能而寫下的「數字黃金」。 對於一家公司而言,遷移這些資產的成本是天文數字。這不僅僅是「翻譯」程式碼,更是:
這些程式碼資產如同一條條沉重的鎖鏈,將企業牢牢鎖定在NVIDIA的硬體上。放棄它們,等於放棄了過去十年的巨額投資。這就是第二層引力鎖定。 第三層引力(內層):人力資本的定居者
再往裡走,我們遇到了引力場中最「活」的部分:全球超過400萬的CUDA開發者。他們不是冰冷的程式碼,而是適應了這個生態系統的「定居者」。 他們的技能、經驗,甚至「肌肉記憶」都與CUDA深度綁定。
引力核心:性能與信任的恆星 所有引力的來源,是這個系統最中心的、熾熱的「恆星」——NVIDIA軟硬體協同所帶來的極致性能和無可動搖的信任。 這不僅僅是紙面上的浮點運算次數(FLOPS)更高,而是一種「它就是能用」(It just works)的黃金標準。當你投入數百萬美元、耗時數月訓練一個大型語言模型時,你最無法承受的就是穩定性問題、驅動崩潰或無法預期的錯誤。 NVIDIA通過數十年的迭代,將硬體、驅動、CUDA運行時、函式庫緊密地耦合在一起,形成了一個高度穩定、性能可預測的「黑盒子」。 開發者信任它,企業依賴它。這種由時間和無數成功案例建立起來的信任,是挑戰者最難複製的東西。 AMD的GPU或許在某些特定任務上能達到理論峰值性能,但在通用性、穩定性和生態成熟度上,與NVIDIA存在「代差」。 這個由性能和信任構成的引力核心,是整個CUDA帝國的基石。正是它的存在,才讓外層的生態、程式碼和人才甘願被其引力捕獲,圍繞它旋轉。 Warren Buffett曾說,他尋找的是擁有寬闊且持久護城河的企業。 NVIDIA用CUDA構建的,正是這樣一條教科書級的護城河。這四大引力共同指向一個結論:NVIDIA在可預見的未來,將繼續享受行業的絕大部分利潤。 這條由「硬體性能 + 軟體鎖定 + 生態依賴」構成的護城河,最終轉化為NVIDIA最令華爾街垂涎的東西:無可匹敵的定價權和驚人的毛利率。 這在財務報表上體現得淋漓盡致。NVIDIA的數據中心業務毛利率穩定在 72% 至 75% 的驚人水平,這在硬體產業中幾乎是聞所未聞的,更像是壟斷性軟體平台的利潤結構。 相比之下,其主要競爭對手AMD的毛利率約在 50-53% 左右。這超過20個百分點的差距,就是CUDA護城河的直接價值體現。 這種超高利潤,讓NVIDIA有充足的彈藥投入到下一代技術的研發中。2025財年,其研發投入高達 129.1億美元,比前一年增長近49%。 這個數字本身就超過了AMD的全年研發預算,讓NVIDIA能夠持續發動「速度戰」,不斷拓寬護城河,形成一個強大的正向循環:軟體護城河 → 高定價權 → 高利潤 → 高研發投入 → 更強的軟硬體 → 更深的護城河。
第四章:挑戰者聯盟的「反引力牆」之戰歷史上從不缺乏挑戰巨人的勇士。在AI計算的戰場上,面對NVIDIA這座不可一世的巨像,挑戰者們組成了鬆散而目標一致的聯盟。他們的主要力量來自三股:AMD的鏡像追趕、Intel的開放標準,以及開源社區的游擊戰。 一、 AMD與ROCm:鏡像世界的追趕者
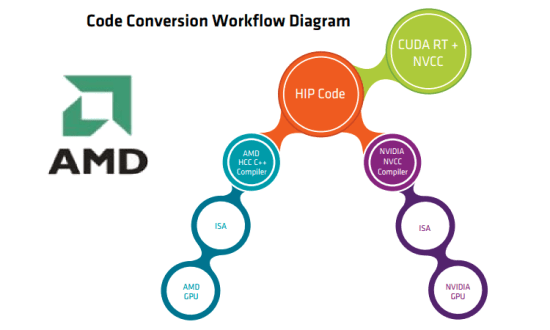
在所有挑戰者中,AMD是與NVIDIA最相似、也是最直接的對手。它的策略可以被概括為:成為CUDA的「鏡像」。 ROCm的誕生與使命: 它的核心戰略是 「開放」。ROCm是開源的,允許開發者自由修改和客製化,以此來對抗CUDA的「封閉」和「廠商鎖定」。 核心武器:HIP (Heterogeneous-compute Interface for Portability) 這使其在處理大型模型推理時具有天然優勢,吸引了Meta和微軟等超大規模客戶的採用。 為了撬動CUDA的程式碼壁壘,AMD祭出了關鍵武器——HIP (異構計算可移植介面)。HIP是一個C++ API,允許開發者編寫可在AMD和NVIDIA GPU上同時運行的程式碼。
同時,AMD提供了「HIPIFY」工具,可以自動將現有的CUDA程式碼轉換為HIP程式碼,轉換成功率通常在80-95%之間。 這個策略非常聰明。它試圖直接解決第三章提到的「程式碼資產引力」問題。AMD在對開發者說:「你不需要拋棄你過去十年的心血,只需要運行一個轉換工具,你的寶貴資產就能在我的平台上發揮價值。」 殘酷的現實,硬體優勢下的軟體困局: Continue reading this post for free in the Substack app
|
Tuesday, October 28, 2025
70%毛利的秘密:CUDA,NVIDIA的「軟體稅」- 深度分析第17期:NVDA護城河 (下)





Subscribe to:
Post Comments (Atom)
No comments:
Post a Comment